
只做判斷、不寫文字的 AI,換題不用重新訓練,答錯了仍要靠人發現
二十多年前,張Sir和團隊開始做內容分析、數據挖掘和輿情分析。研究員先寫好一本編碼簿(codebook,列明每個類目怎樣定義、怎樣判斷的手冊),編碼員對着一疊疊新聞,逐篇回答同一組問題:這篇報道講哪個議題,對涉及的某政府部門是正面、中立還是負面,要不要列入當日重點。答案早就列好,只能選,不能自由發揮。
後來數據多了,人手追不上,便改用機器學習。意圖分類、風險評分、情感分析,做法大同小異。先人工標註幾千條樣本,訓練一個模型,數據丟進去,分個類、打個分數、算個機率,把握大的自動處理,把握小的由人複核。這類分類器在大語言模型出現之前已經遍地都是,在自家服務器上就能跑,毋須上雲。
所以最近看到 Jev 在開發者圈子突然走紅,張Sir第一個反應是有點疑惑,這個概念不是很久以前就有了嗎?近幾年 AI 行業的技術和營銷越來越難分開看,一樣東西走紅,未必等於它是新東西。細看下去,Jev 的做法又確實有幾處跟過去不同。
一個只負責判斷的模型
Jev 是 TypeSafe AI 在2026年9月推出的模型,創辦人 Diogo Almeida 曾在 OpenAI 參與 ChatGPT 背後的研究。官方稱它為 System One Model,名字借自心理學家 Kahneman 對快思考與慢思考的區分。大家熟悉的 GPT、Claude、Gemini 、Deepseek和Kimi等,主要負責生成內容,Jev 不寫文字,只做判斷。一封客服電郵進來,系統要知道的往往只是一個標籤,例如「帳單問題,96%」,然後把信轉給帳務部。Jev 回傳的就是這種東西。
它有三種問法:從幾個選項中選一個,按標準打分,或者判斷一句話成立的機率。每個答案都附一個機率,程序照着決定下一步。有開發者把它形容為一個懂自然語言的 if/switch,也就是程序裡按條件分岔的那幾行語句。官方公佈的速度是每次70至500毫秒,價錢是每百萬輸入 token(模型計算文字量的單位)0.042美元,輸出不收費。
以前難在哪,現在不同在哪
以前做分類,一個任務一個模型。客戶意見分主題、客服信件分流、網上內容審核,這三類張Sir團隊都做了很多年,最花時間的往往不是訓練,是類目一改就要重來。客戶要把一個類目拆細,新議題冒起要加類目,舊類目用久了要合併,這類調整經手過的多不勝數,每一次都要重新標註一批樣本、重新訓練。網上出現一種新的詐騙說法,審核模型也要等新樣本收夠才認得出。
Jev 的做法是在調用時才寫題目和選項。同一個模型,今天用來分客戶意見,明天用來判斷一條帖文是否涉及詐騙,改幾行文字便可以,這一點最值得看。不過這個做法並非 Jev 首創。2019年前後已有零樣本分類(zero-shot classification,不用預先標註、調用時才告訴模型有哪些類別),大語言模型面世後,用提示詞叫它分類更是常見。
以往的零樣本分類模型快而便宜,理解力有限;換成大語言模型,理解力上去了,速度和價錢又成了問題。Jev 想做的,是讓一個專用模型同時具備自然語言理解、低延遲、機率輸出和低價格。它的理解力和機率是否真的較可靠,目前主要只有官方評測,還要等獨立測試。
Jev 引起開發者注意,也跟 AI 系統的用法在變有關。大語言模型出現後,大家一度習慣甚麼都丟給大模型;現在開始有人回頭想,單純的分類、判斷和路由(決定任務由誰處理),也許可以交給更專門、成本更低的模型。AI Agent(能自行分步完成任務的 AI)的流程裡,充滿這類小判斷:下一步用哪個工具,這個結果要不要再查,任務該由哪個模型處理。每一個都叫通用大模型來判斷,往往較慢,也較貴。比較合理的分工,是由 Jev 做分類和判斷,理解、推理和寫作仍由大模型負責,動作則由程序執行。
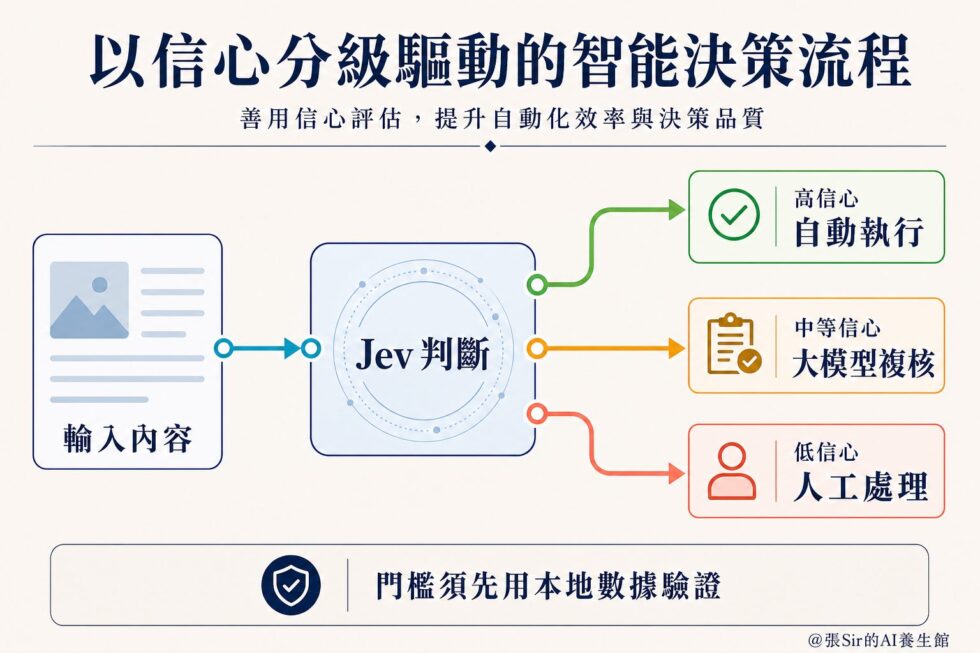
有了機率,分工便有依據。機率高的自動執行,中等的再由大模型判斷,低的轉人工處理。以前團隊也按機率分流,只是在一個模型內部分;現在分流的對象,變成了不同的模型和人。
開源項目 fast-jev-compaction 示範了另一種用法。它讓 Jev 替寫代碼的 AI 助手清理記憶,逐條判斷舊的工具調用和結果還要不要,過時的刪走或截短,留下的一字不改。以往這一步多數由大模型寫摘要,容易漏掉檔案路徑、錯誤訊息這類細節。Jev 不用寫,只判斷甚麼該留、甚麼可以忘。這也帶出一個問題:AI 每一次真的都需要生成文字嗎?
優點和要留神的地方
Jev 快、便宜、輸出格式固定,機率可以直接用來設定自動化的門檻,前提是門檻先用自己的數據驗證過。它的限制同樣要看清楚。Jev 不寫文章、不作解釋,答案範圍要預先定好,題目寫得含糊,結果也會含糊。官方把「不會幻覺」界定為不會產生預設選項以外的答案;答案落在選項之內,選錯仍然可能。做輿情的人都知道,把一條負面帖判成中立,比格式出錯麻煩得多,因為表面上看不出問題。
官方公佈的數字也要打個折扣,首頁那句「快193.6倍、省444.6倍」出自自家設計的測試,官方也承認屬偏高一端;答對與否,是跟兩個大模型的平均答案比,並非由專家核定。完整的模型架構、參數規模、訓練細節和可重現的論文,至今都未公開。繁體中文、粵語和中英夾雜的表現,截至截稿,也未見公開評測。
這幾年 AI 新名詞太多,一個東西剛出來就被捧成未來,過一陣子大家又集體遺忘。所以張Sir現在習慣先等一下,看它解決了哪些以前很難解決的問題,還是把以前就有的東西,用新一代 AI 的方式重做一次。以目前公開的資料,下結論還太早。
檢驗這類模型,可以借用內容分析的老方法
在獨立評測出來之前,機構可以先自己測。換題變得容易,題目出得好不好就更要緊,類目要互斥、要窮盡、邊界要清楚,這是編碼簿的基本功。判斷準不準,要拿人工編碼作標準答案。兩位受過訓練的編碼員先各自判斷同一批樣本,計算彼此的一致程度(業內稱為編碼員間信度);達到要求後,分歧的個案再經討論或由第三人裁決,得出一套人工確認的標準答案(業內稱為金標準),最後拿模型的答案來比較。近日有人拿 Jev 跟大模型分揀同一批新聞,兩邊結果九成四一致,便說 Jev 好用;可是兩邊都沒有跟人工答案核對過,一致不等於正確。
學術界和市場使用內容分析這套方法已有幾十年,工具也現成。有興趣的讀者可參考DiVoMiner 平台,它同時支援人工編碼、AI 編碼和信度測試,不少知名高校的師生都在用。在 Google Scholar 上,可以檢索到不少以它做內容分析的論文,當中不乏 SSCI(社會科學引文索引)期刊。
例如 Chang 等人(2021)比較了內地、香港和台灣十年間三萬多篇中文新聞;Law 等人(2025)收集香港親子論壇 Baby-Kingdom 上一萬七千多條有關中醫的留言,按八個主題的編碼簿,在平台上做情感和語義網絡分析;Zhang 等人(2023)分析網上醫患對話,兩位編碼員在平台上獨立編碼一百段樣本,信度係數達0.86(1代表完全一致)。
同樣的方法也可以核對模型給出的機率。模型說有九成把握的那批答案,實際答對多少,要用本地樣本算過才知道,廠商的整體數字不能直接沿用;類目一改,又要重算一次。繁中、粵語和中英夾雜的本地語料,正是 Jev 還沒有公開評測的部分,用在本地場景之前,這一步省不得。哪些數據可以送出機構做測試,也要先按敏感程度分清楚。
本地知識有多重要,團隊做過一次內部實驗,張Sir在〈當 AI 從個人助手走進企業工作〉介紹過。同一組15宗政務寫作任務,改良版的平均質量分由62.9升至77.5,並由實際用戶並排比較兩個版本。改善主要來自清楚的任務要求、本地知識和人工反饋,單靠換模型做不出來。那次測的是寫作,判斷類的任務,相信道理也相通。
類目用久了也會過期,公司部門改名、新議題冒起,編碼簿和測試樣本都要有人定期更新;模型換了新版本,舊的門檻也要重測。〈政府公文 AI 的第 90 天〉一文談的正是這件事。
Jev 值得一試,試的時候拿自己的數據,挑幾道常見的判斷題,跟人工的答案對一次,心裡便有數。
參考資料
張Sir(2026年8月21日)。當 AI 從個人助手走進企業工作。張Sir的AI養生館。https://www.anguscheong.net/2026/08/21/ai-agent-enterprise-work/
張Sir(2026年9月2日)。政府公文 AI 的第 90 天。張Sir的AI養生館。https://www.anguscheong.net/2026/09/02/government-document-ai-day-90/
Almeida, D. (2026, September 15). Introducing System One models & Jev. TypeSafe AI. https://typesafe.ai/blog/introducing-system-one-models-and-jev
Chang, A., Schulz, P. J., Jiao, W., & Liu, M. T. (2021). Obesity-related communication in digital Chinese news from Mainland China, Hong Kong, and Taiwan: Automated content analysis. JMIR Public Health and Surveillance, 7(11), e26660. https://doi.org/10.2196/26660
Law, M., Ho, K. H., & Cui, X. (2025). Exploring Hong Kong public attitudes and concerns about traditional Chinese medical treatments: A study on discussion forum responses. International Journal of Pharmaceutical and Healthcare Marketing, 19(3). https://doi.org/10.1108/IJPHM-05-2024-0039
Tran, T. (2026). fast-jev-compaction [Computer software]. GitHub. https://github.com/tamaratran/fast-jev-compaction
Zhang, W., Zhou, F., & Fei, Y. (2023). Repetitions in online doctor–patient communication: Frequency, functions, and reasons. Patient Education and Counseling, 107, 107565. https://doi.org/10.1016/j.pec.2022.11.007
本文經「張Sir的AI養生館」授權
[原文出處:https://www.anguscheong.net/2026/09/23/jev-system-one-ai-decision-model/]
 繁體中文
 简体中文
 English
 Português